
GPT-6.2 Astra 与 Sol 发布评测:价格、跑分和开发者选型
更新日期:2026年11月18日
GPT-6.2 Astra 与 GPT-6.2 Sol 于 2026 年 11 月 17 日发布。Astra 定位于高难推理、复杂编码和专业任务,Sol 则以更低的 API 价格覆盖日常开发。本文整理官方模型页和发布资料中的价格、规格与基准数据,并归纳首批体验者反馈;第三方短测不能代表所有项目表现,实际选择仍应以自己的任务集为准。
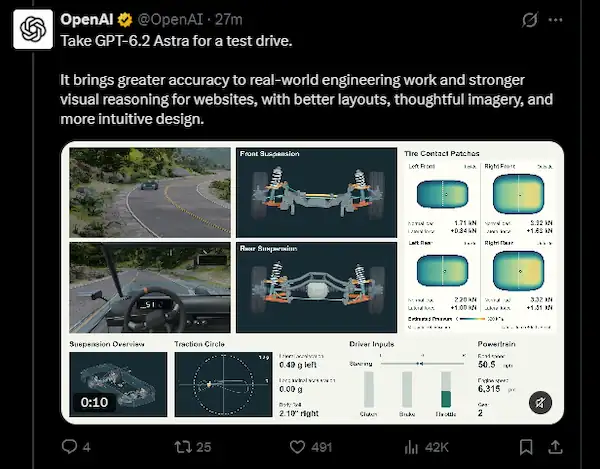
图:OpenAI 发布 GPT-6.2 Astra 与 GPT-6.2 Sol 的消息截图。
本文主要介绍模型的发布评测、价格、跑分和开发者选型,如果你主要想体验 GPT-6.2 Astra 和 Sol 模型,可以使用接入 ChatGPT API 的中文版服务。例如,
- Lazyman.ai 中文版
- Luck.ai 镜像版
这两个服务都是第三方 AI 平台,不是 OpenAI。具体模型、额度和服务规则以平台当前页面为准。
一、GPT-6.2 Astra 与 Sol 的定位和价格
按 OpenAI 当前模型页列出的标准 API 价格,Astra 每百万输入 Token 为 8 美元、输出 40 美元,缓存读取为 0.40 美元;Sol 为输入 2 美元、输出 10 美元,缓存读取 0.10 美元。两款模型的 Batch 处理按标准价格五折计费,Fast 模式按两倍费率计费。价格可能调整,调用前请核对官方 GPT-6.2 Astra 模型页及最新模型指南。
| 项目 | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| 标准输入价格(每百万 Token) | $8 | $2 |
| 标准输出价格(每百万 Token) | $40 | $10 |
| 缓存读取(每百万 Token) | $0.40 | $0.10 |
| 适合优先评估的任务 | 复杂、多步骤、专业任务 | 日常编码、脚本与常规任务 |
例如,10 万输入 Token 加 2 万输出 Token,在不考虑缓存、工具调用和重试时,Astra 约为 1.60 美元,Sol 约为 0.40 美元。这个估算只比较模型 Token 费用,实际账单还会受推理强度、输入长度、缓存命中和工具计费影响。
Astra 的上下文窗口为 1,050,000 Token,最大输入约 922K,最大输出 128K;支持文本和图片输入、文本输出。输入超过 272K Token 时,官方按整次请求对输入和缓存价格收取两倍、输出收取 1.5 倍。长上下文不等于每次都应该提交完整资料,检索和分块仍有助于控制费用与延迟。Astra 支持 low、medium、high、xhigh、max 等推理强度;API 不接受 none。OpenAI 建议新接入从 medium 开始,旧请求若使用 none 或 minimal,迁移时应检查并调整参数。
二、官方跑分显示了哪些差异
下表整理自 OpenAI 发布页的模型对比图,属于厂商在各自评测设置下公布的结果。不同任务的测量方法、工具配置和推理档位不同,分数不能直接当成日常体验排名。
| 基准 | GPT-6.2 Astra | GPT-6 Astra | GPT-6.2 Sol | Claude Fable 5.2 |
|---|---|---|---|---|
| Agents’ Last Exam v1.1 | 77.6% | 73.1% | 73.0% | 72.8% |
| Terminal-Bench-Science 0.1 | 77.1% | 68.1% | 68.0% | 73.3% |
| GDPval v2(内部评测) | 50.4% | 44.2% | 46.9% | 44.8% |
| FrontierCode 2.0 | 44.2% | 42.8% | 43.8% | 45.7% |
| AutomationBench 1.0.6 | 52.4% | 41.4% | 41.1% | 51.4% |
| BenchCAD 2.1 Core | 82.5% | 62.6% | 73.1% | 83.5% |
| Vals Science Index v1 | 68.4% | 65.1% | 57.8% | 63.7% |
OpenAI 表示,GPT-6.2 Astra 在 Agents’ Last Exam 等长程任务上提高了成绩,同时减少了部分任务的输出 Token。第三方 Artificial Analysis 的评测也显示 Astra 在综合智能指数、3D 交互任务等项目上表现突出;不过该机构报告中的不同档位结果、每任务成本和模型比较依赖具体测试框架。应把这些数据看作候选模型筛选依据,而非对生产表现的保证。
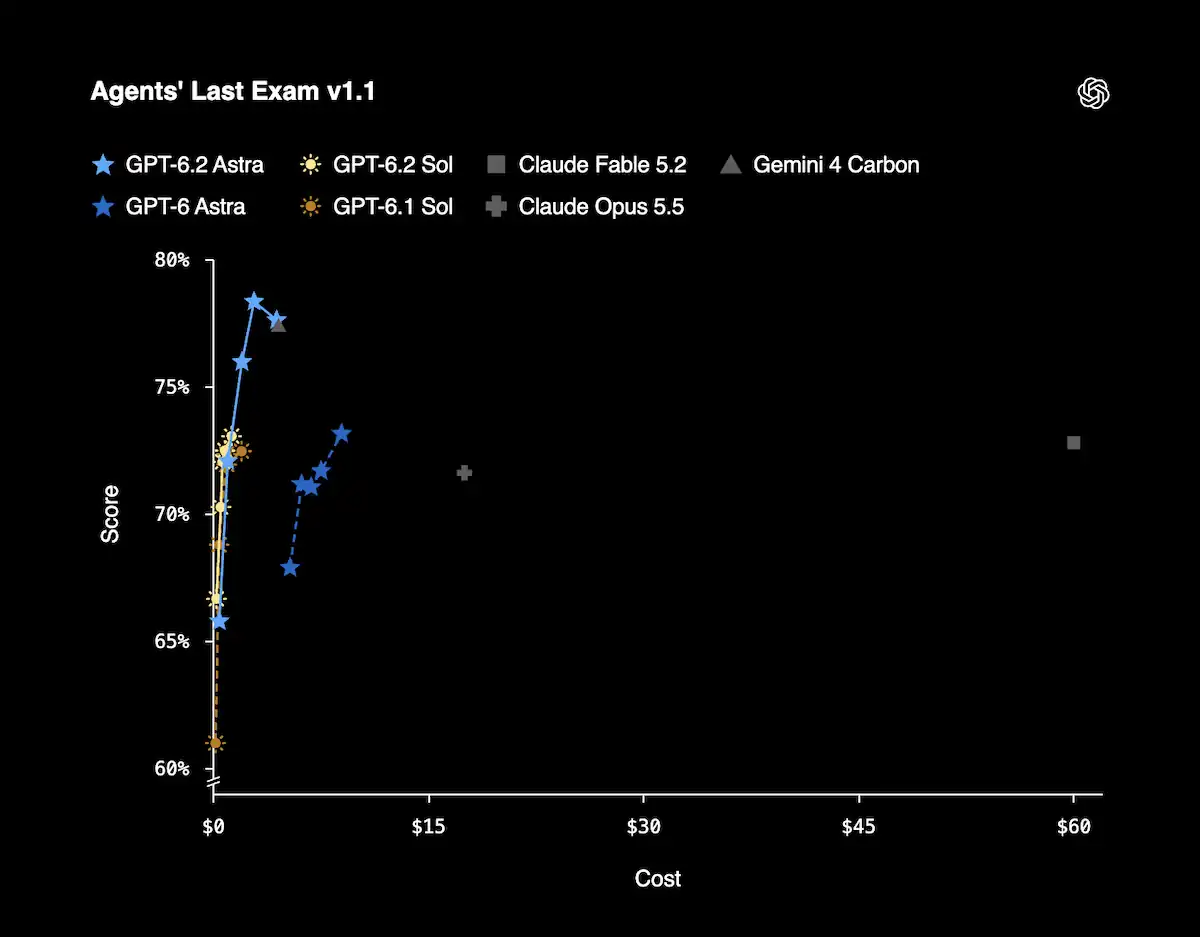
图:Agents’ Last Exam v1.1 的模型成绩对比。
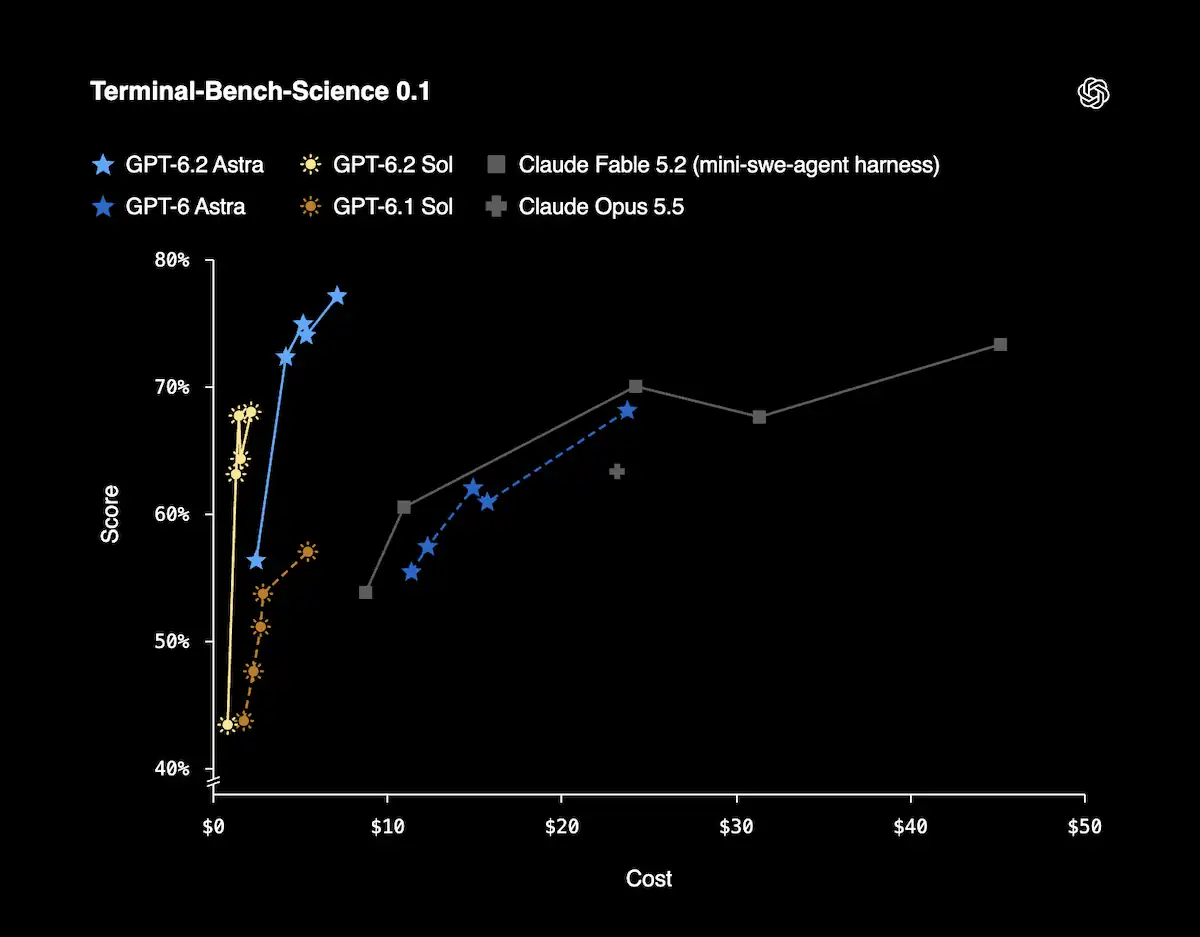
图:Terminal-Bench-Science 0.1 的模型成绩对比。
数据也不是所有领域都由 Astra 领先:FrontierCode 2.0 的表格中 Claude Fable 5.2 高于 Astra,BenchCAD 中 Claude Fable 5.2 也略高。Sol 在 FrontierCode 2.0 上与 Astra 接近,但标准 Token 单价是四分之一。评测更适合帮助团队找到要进一步验证的任务类型,而不是只按单个总分决定迁移。
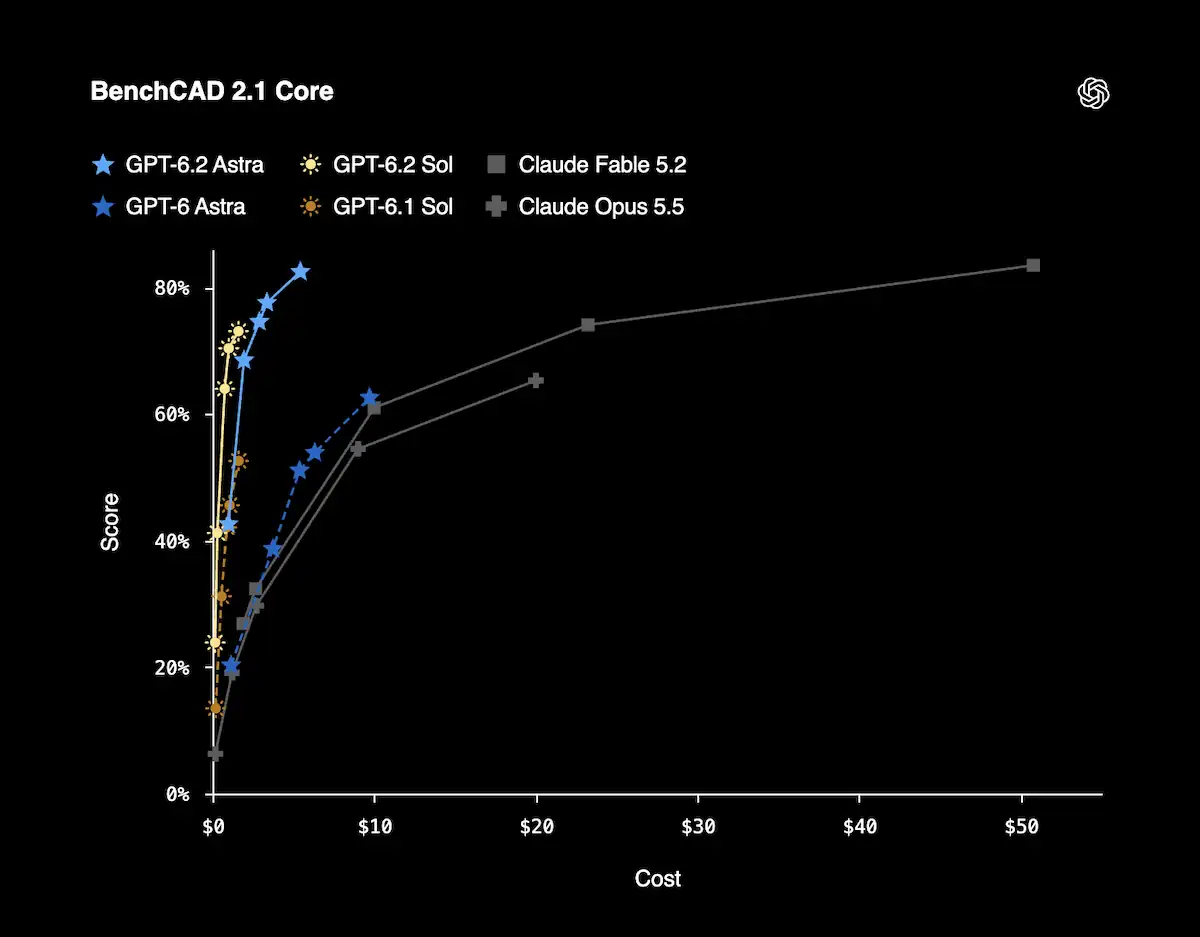
图:BenchCAD 2.1 Core 的模型成绩对比。
三、首批第三方体验:强项与争议
首批体验反馈并不一致。AIHub8 原文作者称,其短时重度测试中 Astra 在后端逻辑和长上下文任务上表现较好,但常规前端组件、响应速度和输出风格仍有不足。作者还报告了约 40 Token/秒的生成速度。这些属于特定账号、时段、任务和测试环境下的个人观察,无法推断所有 API 区域或客户端都会有相同速度。
VentureBeat 汇总的少数早期测试者也呈现两面评价:有人认为模型难以驾驭,监督它的其他模型需要重做结果;也有人肯定其代码审查、3D 和电脑操作能力。早期反馈样本有限,可能受提示词、工具链和任务选择影响。对开发团队来说,更实用的做法是用真实仓库和验收标准测量正确率、延迟、返工时间与总成本。
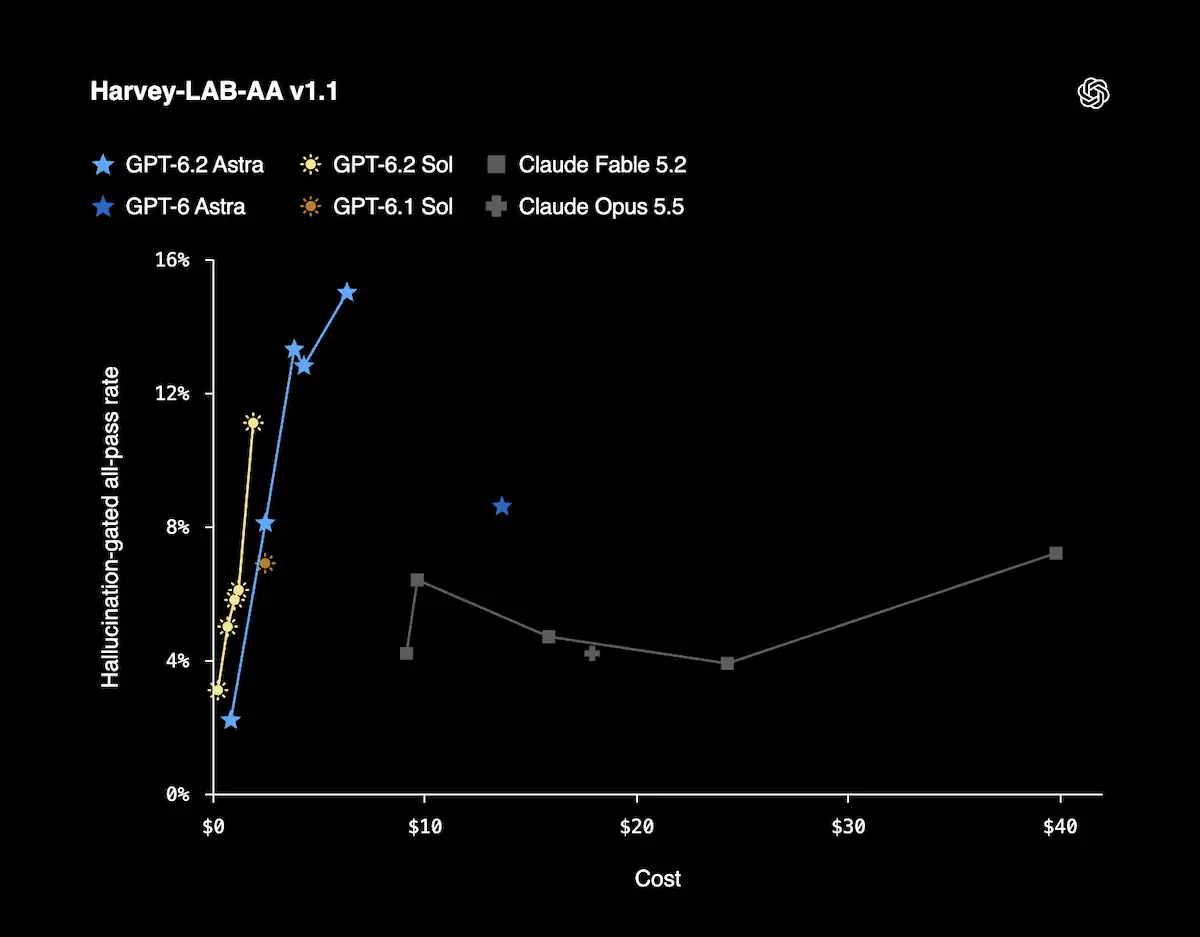
图:Harvey-LAB 相关评测资料截图。
四、GPT-6.2 Astra 和 Sol 怎么选
- 先测试 Sol:日常编码、脚本、数据转换和常规问答,可先用价格较低的 GPT-6.2 Sol 建立质量基线。若它在团队任务集上达到要求,就没有必要为所有请求默认使用旗舰档。
- 把 Astra 用在高难任务:复杂多步骤推理、研究型工作、专业文档、工具编排或失败代价较高的任务,可对比 Astra 是否带来足以抵消价格和等待时间的成功率提升。
- 前端和设计任务做并行比较:基准和首批反馈并未显示 Astra 在所有编码类型都领先。对 UI 视觉、组件细节和交互设计,建议同一需求让候选模型生成,再按项目自己的审美和可维护性标准评审。
- 按任务分流:可以先用低成本模型处理简单步骤,将疑难任务升级给 Astra,并记录升级前后的成功率与账单。任何自动路由规则都应保留失败回退和人工复核。
此前发布的 GPT-6 Astra 发布与 API 指南介绍了前代规格与成本背景。迁移到 GPT-6.2 时,还应检查 reasoning effort、提示缓存参数和请求中的采样参数。官方模型文档对不支持的参数有说明;不要仅通过替换模型 ID 就假定所有旧请求兼容。需要工具调用时,请按官方要求使用 Responses API。
五、常见问题
GPT-6.2 Astra 比 GPT-6.2 Sol 强多少?
不同基准上的差距不相同。官方对比中 Astra 在部分科学、自动化和长程任务上领先,但 Sol 的 FrontierCode 2.0 成绩接近 Astra。应结合你的任务成功率、成本、延迟和人工返工来判断。
GPT-6.2 Astra API 价格是多少?
截至本文更新时,官方列出的标准价格是输入每百万 Token 8 美元、输出 40 美元,缓存读取 0.40 美元。超过 272K 输入 Token 会触发不同计费规则。正式预算请以调用时的官方价格页为准。
Astra 的生成速度是否很慢?
首批用户报告过等待时间较长和输出速度偏慢的情况,但这类观察并非统一基准。服务区域、推理档位、请求复杂度和客户端都会影响延迟,建议在目标环境记录首 Token 时间和完整任务耗时。
GPT-6.2 Astra 适合所有代码任务吗?
不适合仅凭型号判断。复杂后端和多步骤任务可以优先纳入测试;常规前端、样式修改或简单脚本应同时比较 Sol 和其他候选模型,避免支付不必要的高档成本。
结语
GPT-6.2 Astra 与 Sol 提供了高能力旗舰和低成本主力两种选择。官方跑分说明 Astra 在若干复杂任务上取得进展,Sol 则以更低价格覆盖不少日常开发需求;第三方首批反馈提醒我们,基准成绩与实际可用性之间仍有距离。建议从自己的任务集开始,小流量比较质量、总耗时和完整成本,再决定是否调整生产模型路由。
模型名称、价格和可用范围可能变化。本文仅供技术选型参考,API 规格和计费以 OpenAI 官方文档为准。